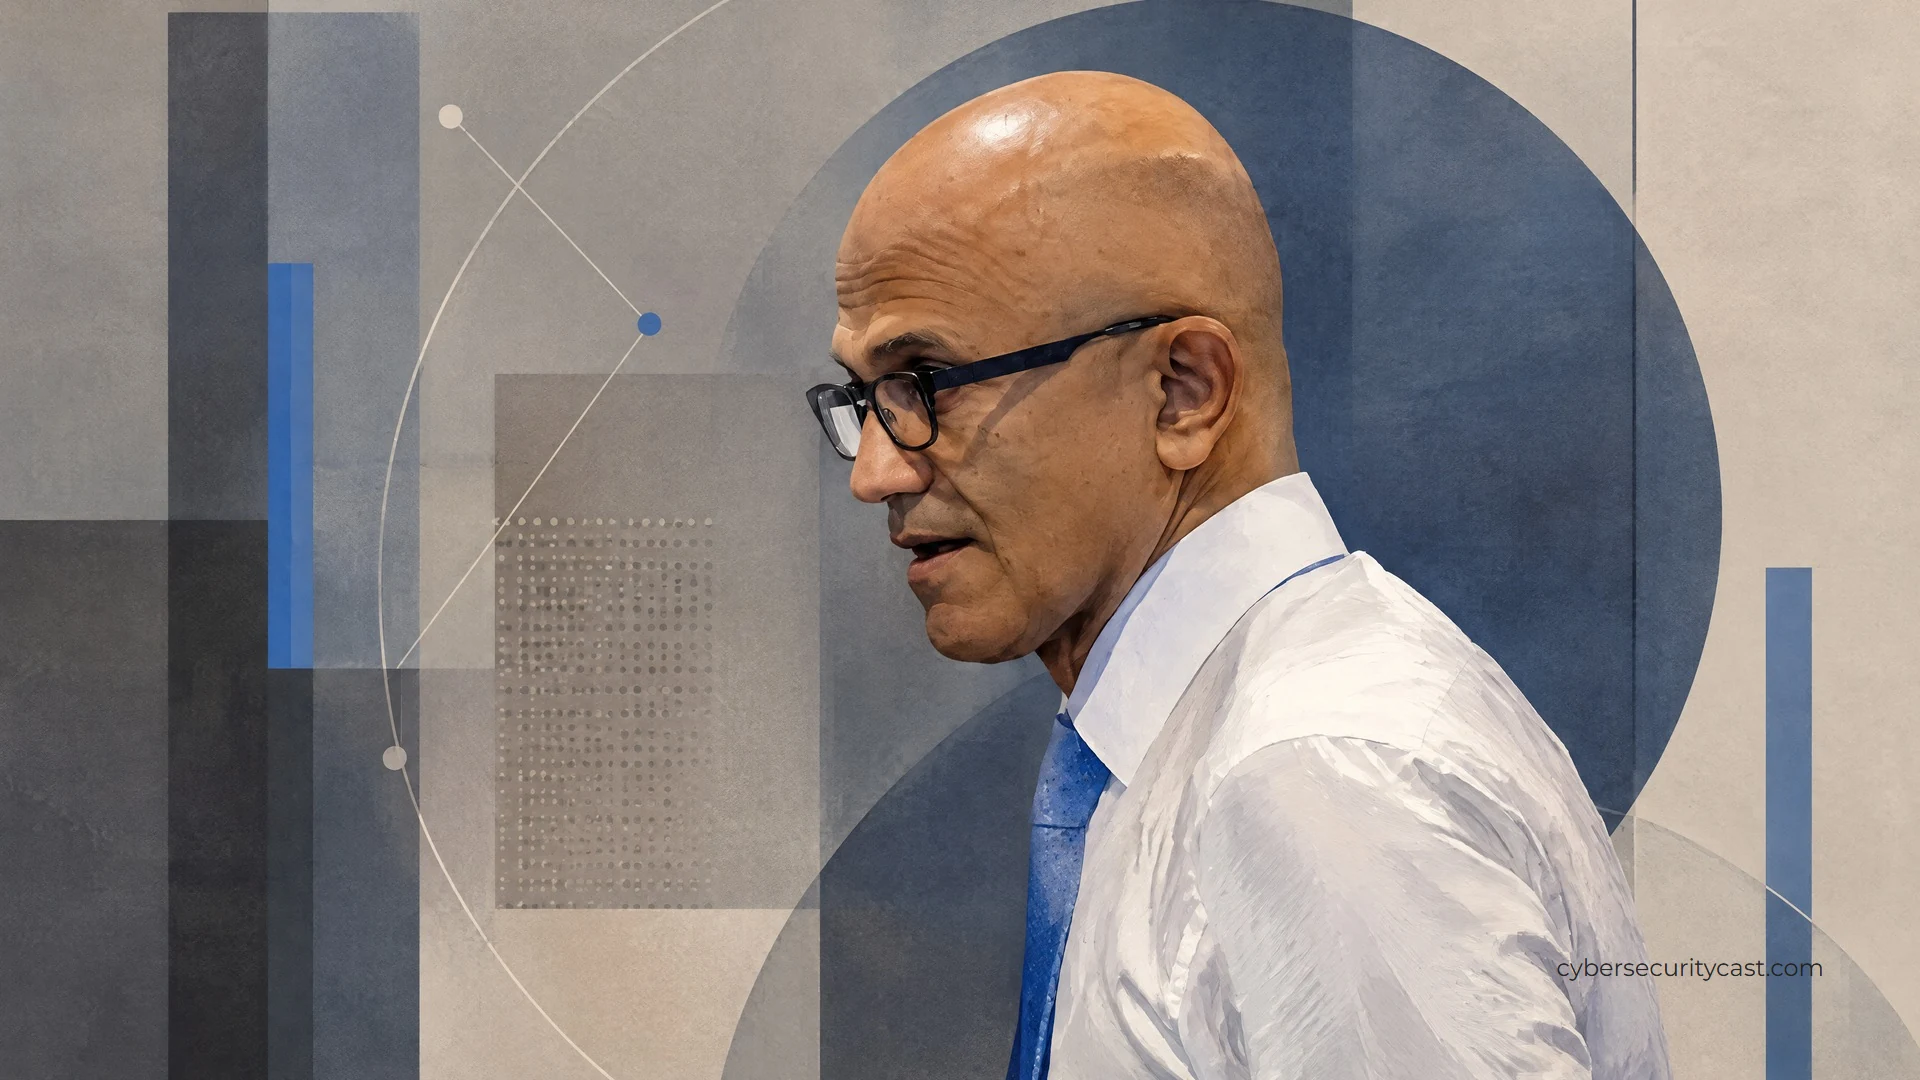
دعا الرئيس التنفيذي لشركة Microsoft، ساتيا ناديلا، إلى معاملة نماذج الذكاء الاصطناعي المتقدمة كمخاطر داخلية وبناء أنظمة تراقبها وتحتويها، في مقال طويل نشره على منصة X في 10 أكتوبر 2026 بعنوان “Models as Insider Risks in the Super Intelligence Era”.
ويظهر النص نفسه بتاريخ 10 أكتوبر على موقع sn scratchpad الذي يربط بحسابي ناديلا على X وLinkedIn. ويقول ناديلا إن البرمجيات التقليدية كان ممكناً تتبع سلوكها إلى مسار برمجي محدد، أما في أنظمة الذكاء الخارق (Super Intelligence) اليوم فلا يمكن ربط سلوك النموذج ومخرجاته بمدخلات تدريب محددة أو بإعدادات أوزان بعينها. ومع ذلك يجري نشر أنظمة وكيلية معقدة بوصول إلى أكثر البيانات حساسية وبقدرة على اتخاذ إجراءات حرجة نيابة عن أصحابها.
ويرى أن المؤسسات لا تستطيع تفويض المسؤولية عما يفعله الذكاء نيابة عنها، وأن تطمينات مزود النموذج لا تعفيها منها. ويقترح فصل توريد الذكاء عن السلطة عليه، بمعزل عن مشكلة المواءمة الصعبة، عبر إحاطة النماذج غير الحتمية بتصميم أنظمة قوي وحتمي وضوابط بشرية وإجراءات تشغيل موثوقة، ومعايير صناعية حيث لا تكفي القائمة.
ويقترح التعامل مع النماذج المغلقة ومفتوحة الأوزان كما تعامل المؤسسات الجهات الداخلية ذات الصلاحيات الواسعة، لأن أي طرف قادر يملك وصولاً إلى أنظمة مهمة قد يخطئ أو يتعرض للاختراق، حتى لو لم يكن خبيثاً بالضرورة. ويذكر أن المؤسسات أرست خلال عقود ممارسات لذلك: تحديد الهوية، وتقييد الصلاحيات، وتسجيل النشاط، وإنشاء حدود احتواء.
ويشترط أن تقع الضوابط التي تحدد ما يصل إليه النموذج وما ينفذه خارجه، استناداً إلى مبدأ في أمن المعلومات يعود إلى السبعينات، مفاده أن البرنامج يجب ألا يستطيع تجاوز آليات فرض صلاحياته أو العبث بها. ويعني ذلك عملياً فصل النموذج عن الإطار الذي ينسق عمله وعن مجال الإجراءات المتاحة له. ويعد شفافية سلسلة التفكير (CoT) شرطاً لا غنى عنه لكنه غير كاف، ويحذر من أن اختبار النماذج لبعضها قد ينتهي بنموذج مبهم داخل طبقة تنسيق مبهمة يراقبه نموذج مبهم آخر.
وتتلخص مقاربته في سبعة مبادئ للمراقبة: تنوع النماذج بحيث لا يصبح نموذج واحد الاعتماد الوحيد لنتيجة مهمة أو المسؤول عن التحقق من عمله، ومراقبة كل شيء بحيث يترك كل إجراء مهم دليلاً مقروءاً للبشر ومحمياً من التلاعب، وإمكان التحقق عبر اختبار النظام كله بما في ذلك الإخفاقات والهجمات، وضوابط مستقلة تحدد ما يصل إليه النموذج، وتدقيق مستقل عن الذكاء الذي يجري تدقيقه، والاحتواء، والإفصاح عن الحوادث.
وفي الاحتواء يدعو إلى افتراض أن النموذج مخترق ومحاصرته من البداية، على طريقة فرامل الطوارئ، بحيث يستطيع شخص مخول إيقاف النموذج مؤقتاً أو إغلاقه في منتصف المهمة. ويضيف أن النماذج الأكثر تقدماً ستحتاج تقنيات احتواء أكثر تقدماً يجب توحيد معاييرها.
أما عند الفشل أو الاختراق فيطالب بإبلاغ المتضررين في وقت مناسب، وبآليات لمشاركة ما جرى والضوابط التي فشلت وكيفية منع تكراره على مستوى الصناعة، بما يشمل تفاصيل التنفيذ التي تغير سلوك الوكلاء أثناء التشغيل. ويختم بأن أجدر أنظمة الذكاء الخارق بالثقة هو الذي يتيح لنا أن نثق بنموذجه أقل ما يمكن.
تتوافق كثير من توصيات ناديلا مع ما طرحه آخرون في القطاع، كالإفصاح عن الحوادث في وقتها والتدقيق المستقل والتحقق من البيانات والاحتواء، لكنه يبدو أنه يذهب في الاحتواء أبعد قليلاً من بعضها.
وكانت Anthropic قد نشرت في 9 أكتوبر تقريراً عن أفعال غير مقصودة لنماذجها أثناء التقييمات والاستخدام الداخلي، أعلنت فيه توسيع قطع الوصول المباشر إلى الإنترنت ليشمل كل تقييماتها الداخلية إلى أن تتأكد من أن ضماناتها تلتقط هذه السلوكيات بموثوقية، وقالت إن أثر الحالات التي رصدتها كان محدوداً.